세미나
에이전트는 스스로의 실패로부터 학습할 수 있는가
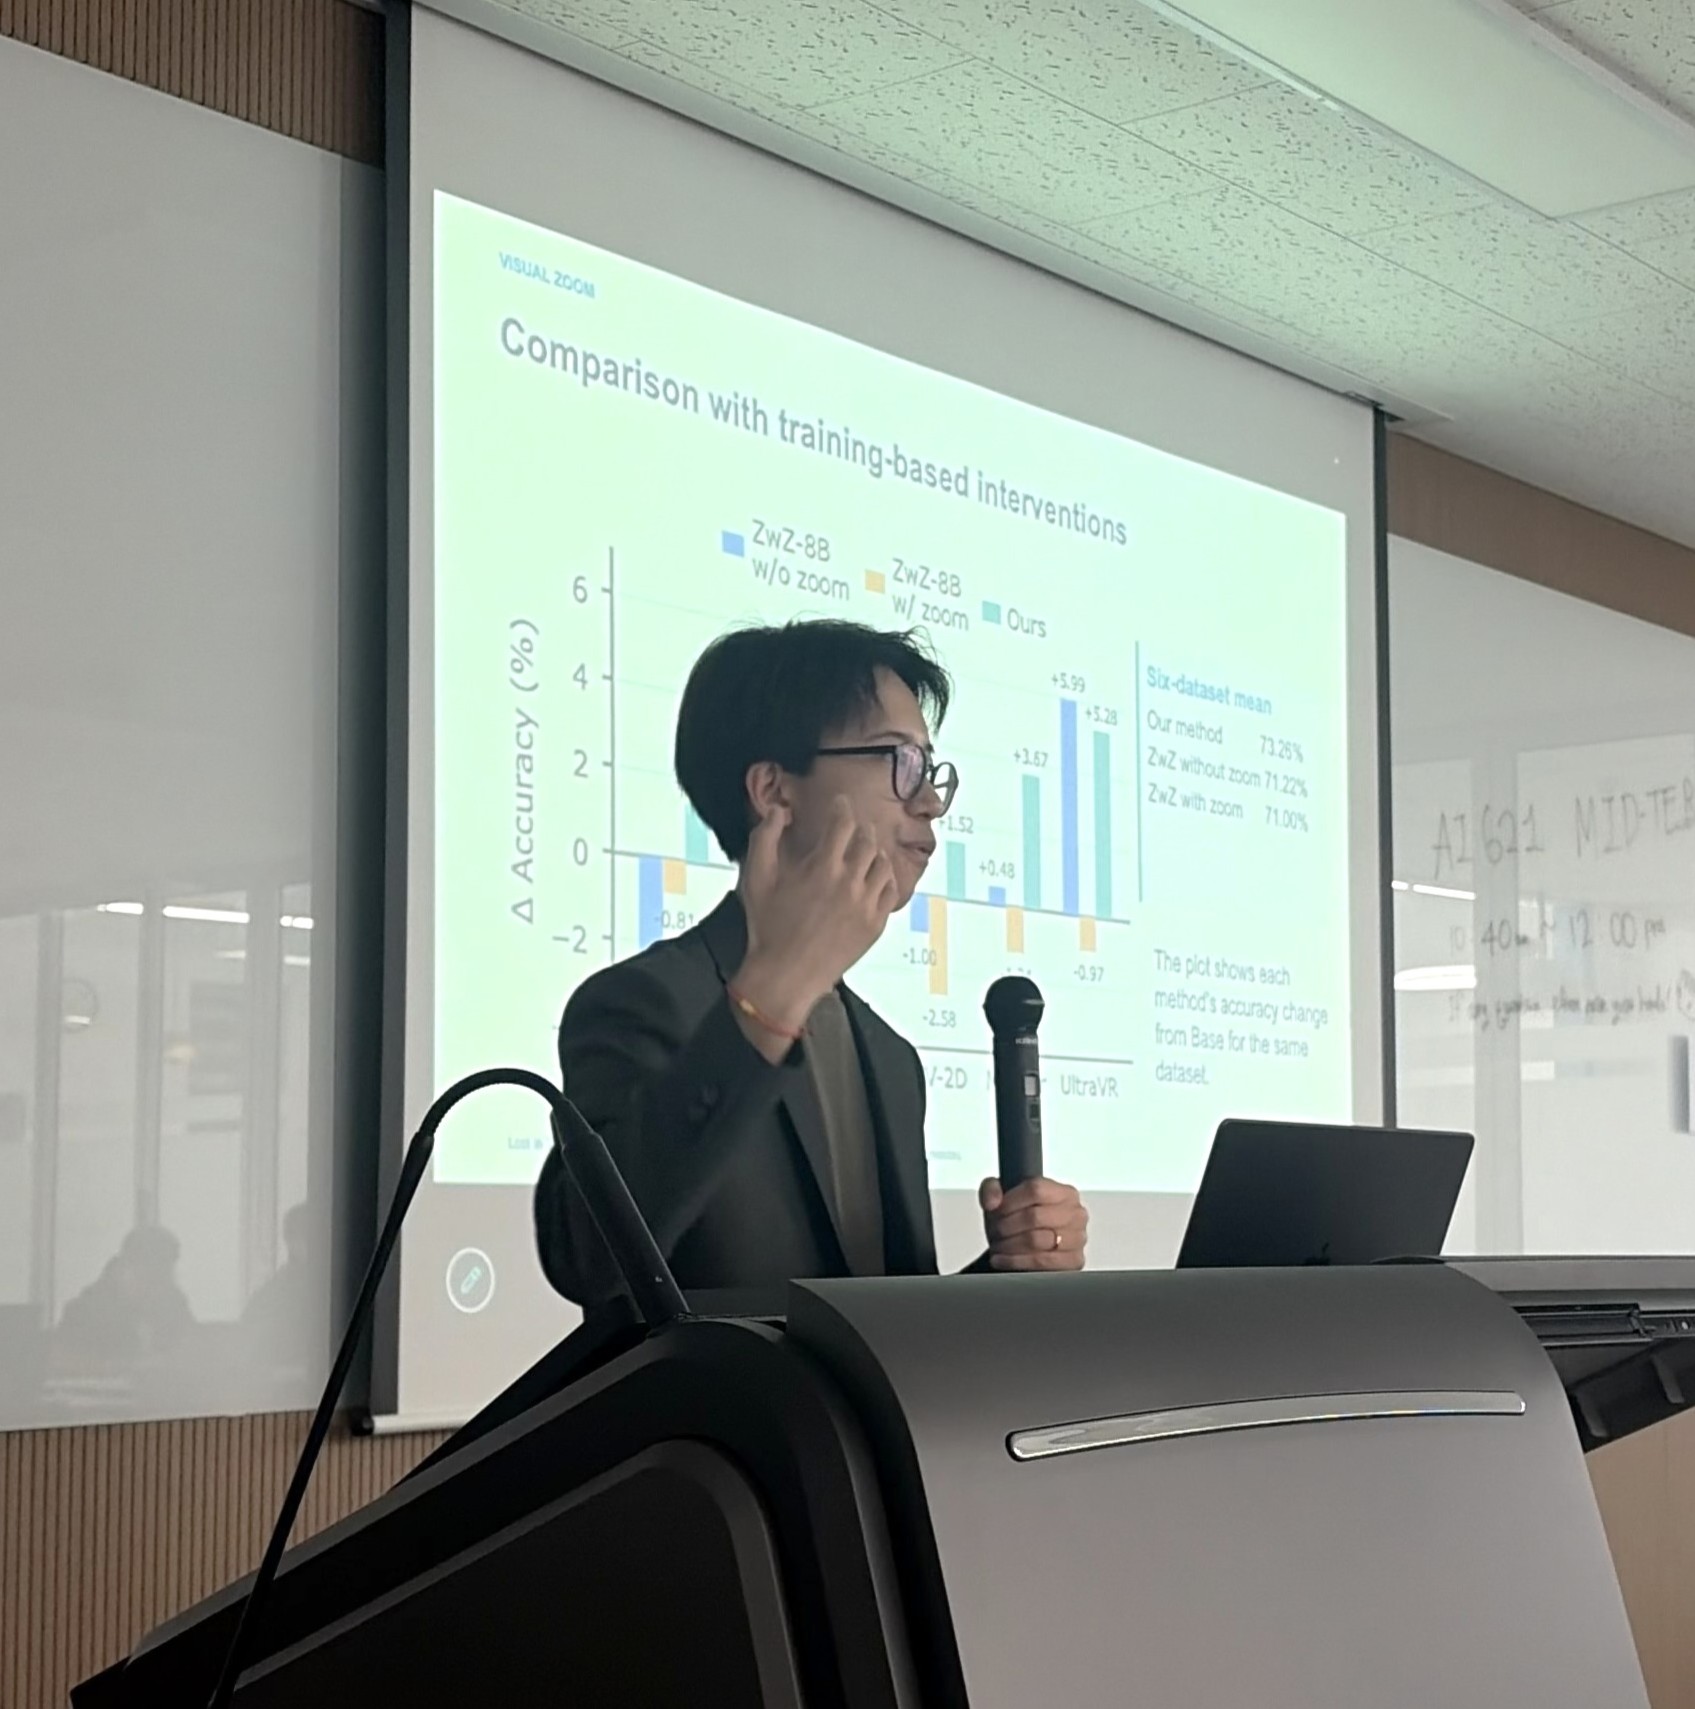
가장 뛰어난 AI 에이전트도 변화하는 환경, 새로운 과제, 드문 실제 사례 앞에서는 실패합니다. 브리티시컬럼비아대학교(UBC) 부교수이자 벡터 연구소(Vector Institute) Faculty Member인 Xiaoxiao Li 교수는 중요한 것은 실패를 피하는 것이 아니라 실패로부터 배우는 것이라고 강조했습니다. Li 교수는 에이전트가 스스로의 실수를 평가하고 진단하고 수정하는 연구를 재귀적 자기개선(Recursive Self-Improvement)으로 가는 길로 제시했습니다.
국가AI연구거점(NAIRL)과 KAIST 김재철AI대학원은 10월 19일 서울 AI 허브에서 Li 교수를 연사로 초청해 “Can Agents Learn from Their Own Failures? Lessons from Vision and Medical Tasks for Recursive Self-Improvement”를 주제로 특별강연을 공동 개최했습니다. 이날 강연에는 KAIST 김재철AI대학원 교수와 대학원생 등 50여 명이 참석했습니다.
Li 교수는 Canada Research Chair(Tier II, 책임 있는 AI)와 Canada CIFAR AI Chair를 맡고 있으며, 구글 방문연구원으로도 활동하고 있습니다. 이번 방한은 국가AI연구거점과 벡터 연구소 간 협력의 일환으로 추진됐습니다.
Li 교수는 먼저 시각 에이전트 사례를 소개했습니다. 검색 도구(RAG)를 쓰면 평균 정확도는 오르지만, 검색된 텍스트가 더해지면서 정답이 오답으로 바뀌는 사례도 상당수 나타났습니다. 샘플 단위로 분석해 보니 늘어난 텍스트가 이미지에 대한 모델의 주의를 약화시키고 있었습니다. 줌인 도구에서도 오답을 낸 경우는 확대된 영역에 주의를 덜 기울이는 경향이 확인됐습니다. 연구팀은 두 경우 모두 추가 학습 없이 주의를 재배분하는 가벼운 기법으로 기존 방법보다 높은 성능을 얻었습니다.
이어 이러한 연구 과정을 자동화한 오픈소스 라이브러리 EvalRx를 소개했습니다. 의학 용어인 처방(Rx)에서 이름을 딴 EvalRx는 모델을 진단해 실패 원인에 대한 가설을 세우고, 이를 검증한 뒤, 프롬프트 수정부터 미세조정까지 단계별 처방을 적용합니다. 모든 과정은 추적 가능한 ‘건강 진단서(health card)’ 형태로 정리됩니다.
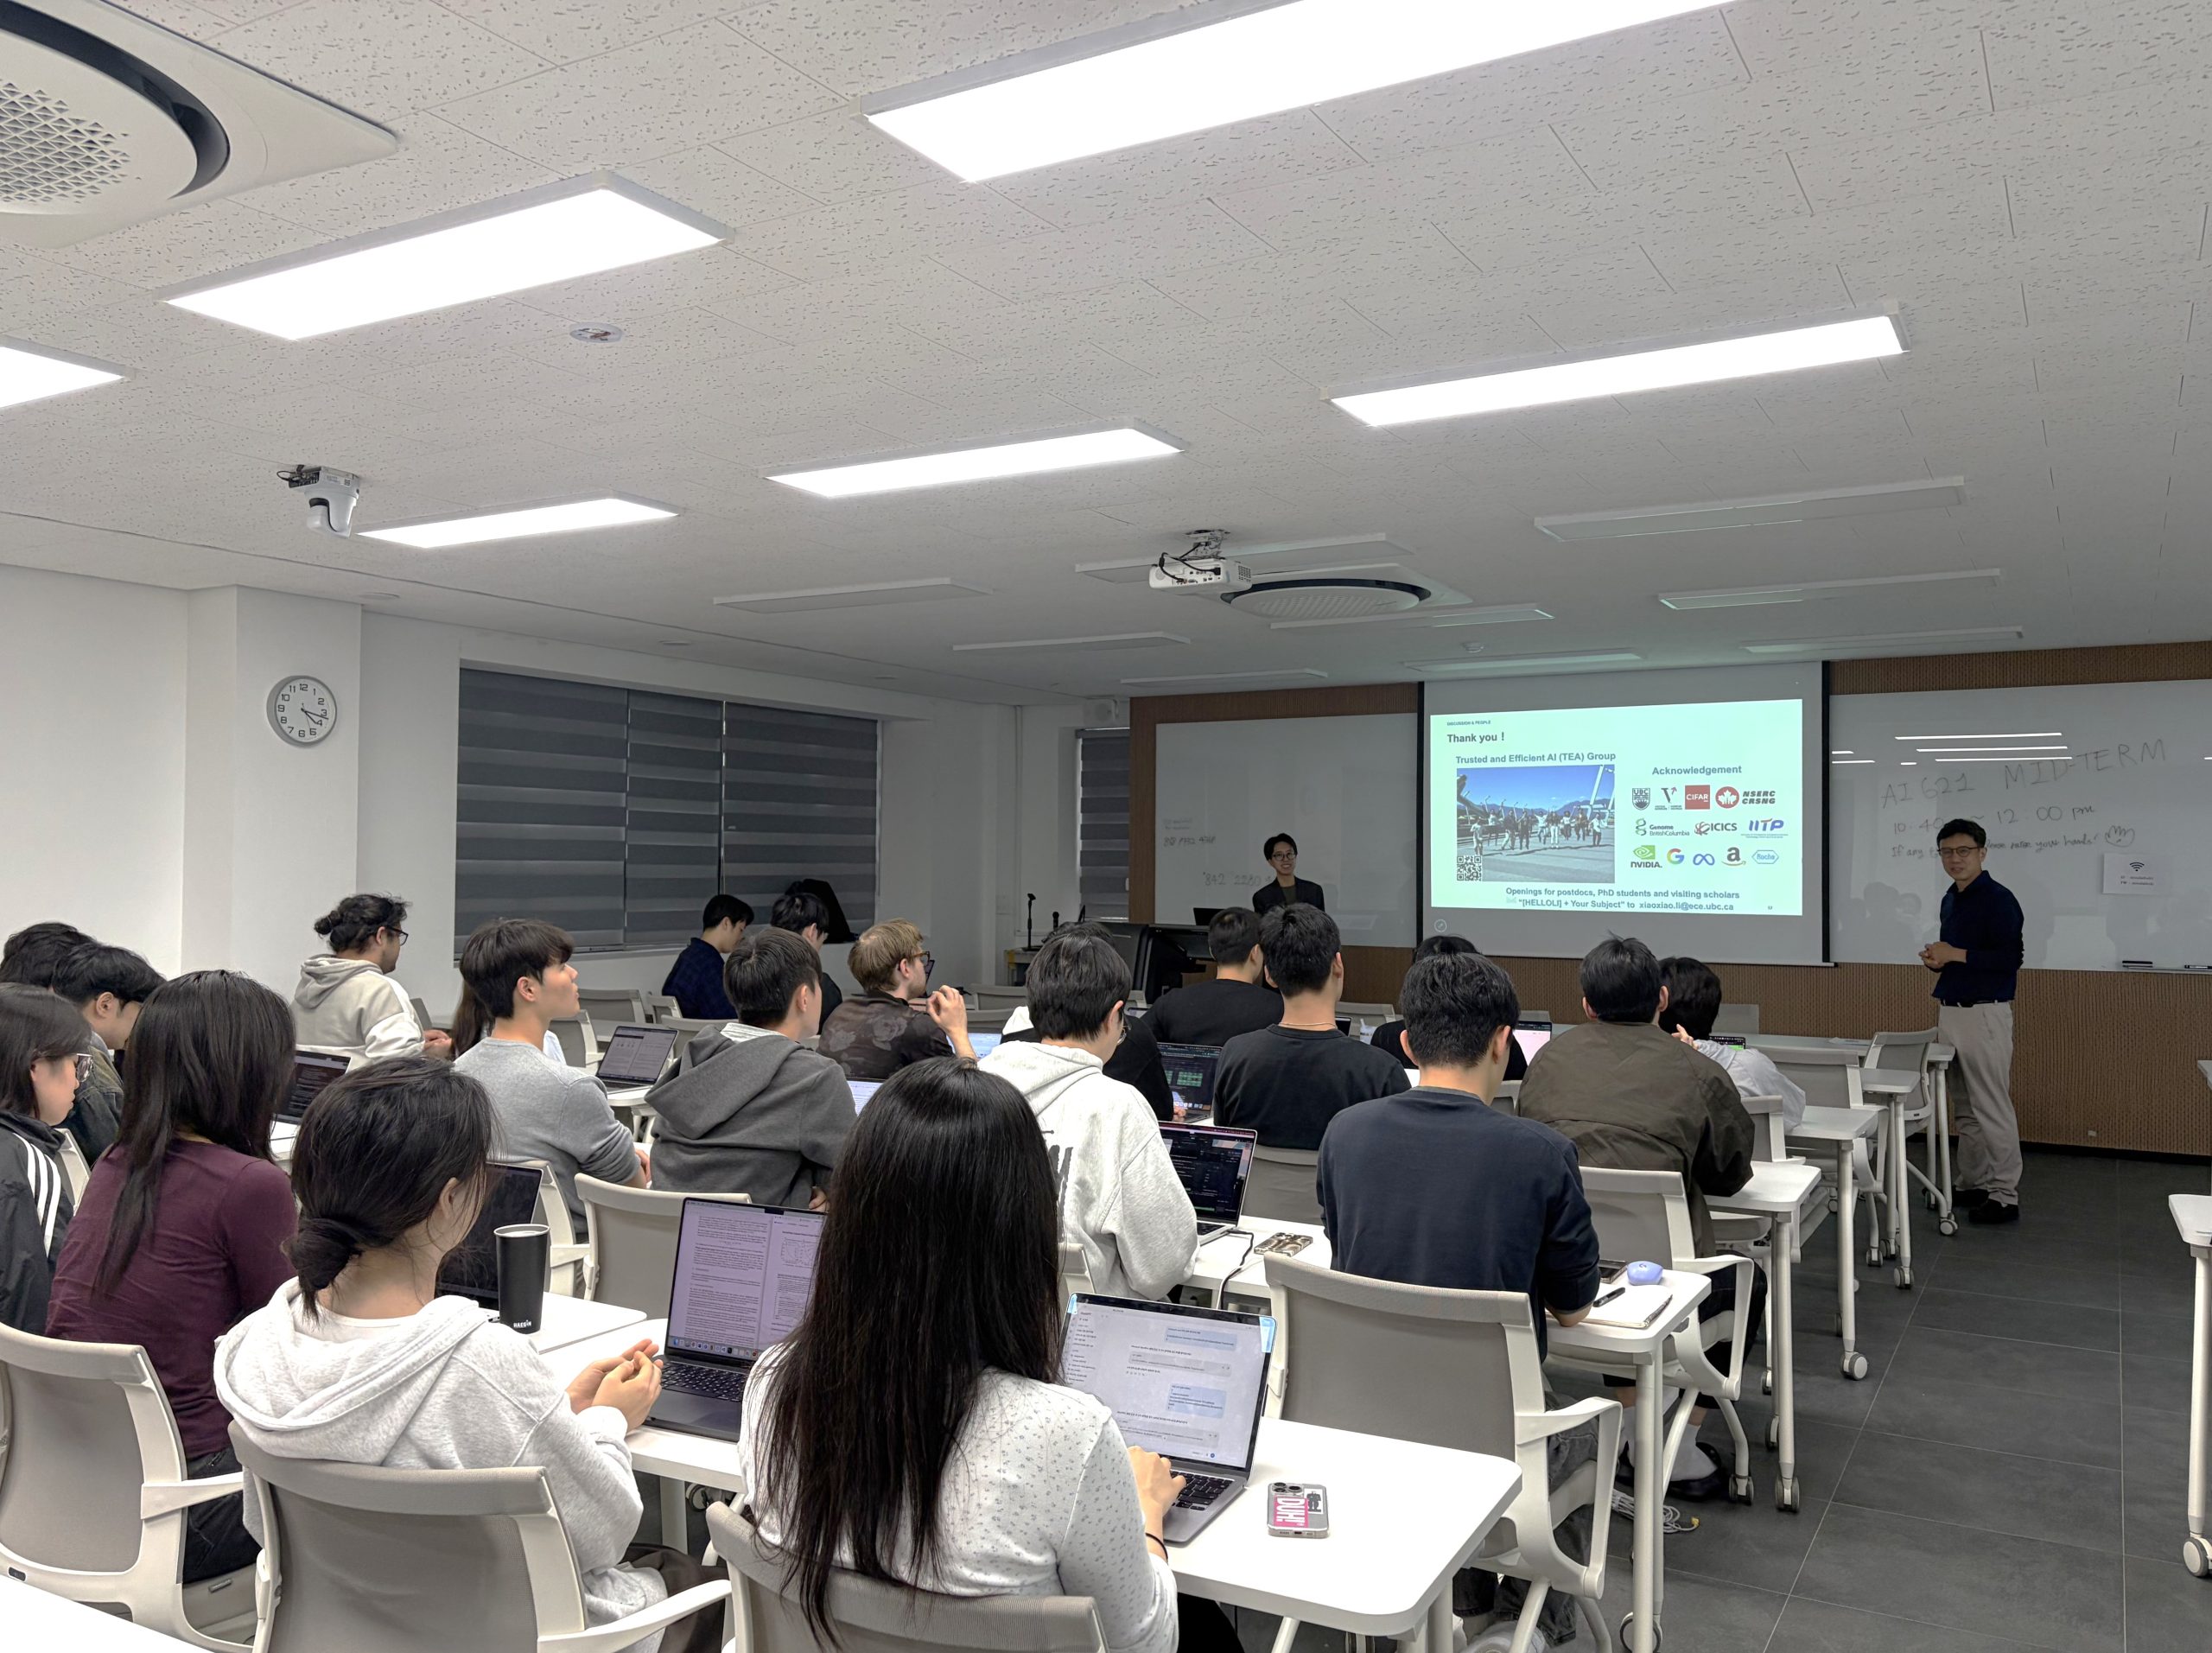
마지막으로 에이전트의 스킬, 메모리, 도구를 최적화하는 연구를 소개하며, 에이전트에게 도구를 더 많이 줄수록 오히려 성능이 떨어질 수 있다고 짚었습니다. 강연 말미에는 학생 리서치 인턴십, 박사후연구원 펠로우십, 교수 대상 방문연구 프로그램 등 벡터 연구소의 교류 프로그램을 소개했습니다.
국가AI연구거점은 앞으로도 세계 최고 수준의 연구자들과의 교류를 지속적으로 확대하며, 국내 연구 커뮤니티와 글로벌 AI 연구 네트워크를 연결하는 역할을 강화해 나가겠습니다.