연구
국가 AI 연구거점 참여 고려대 이성환 교수팀, NeurIPS 2026서 LLM 경량화 연구 발표
국가AI연구거점(NAIRL) 참여 연구진인 고려대학교 인공지능학과 이성환 교수 연구팀이 대규모 언어모델(LLM)의 크기를 줄이면서도 수학 추론과 코드 생성 성능을 유지하는 경량화 기술 ‘GDPruner’를 개발했습니다. 연구 논문 「Generation-Drift-Guided Block Pruning for Large Language Models」는 NeurIPS 2026에서 발표됩니다.
대규모 언어모델은 성능이 뛰어나지만 규모가 커질수록 연산 자원과 운영 비용이 늘어납니다. 이를 줄이기 위해 모델의 연산 블록 일부를 아예 제거하는 블록 가지치기(Block Pruning)가 쓰이지만, 기존 방법은 수학 추론이나 코드 생성처럼 복잡한 과제에서 성능이 크게 떨어지는 한계가 있었습니다.
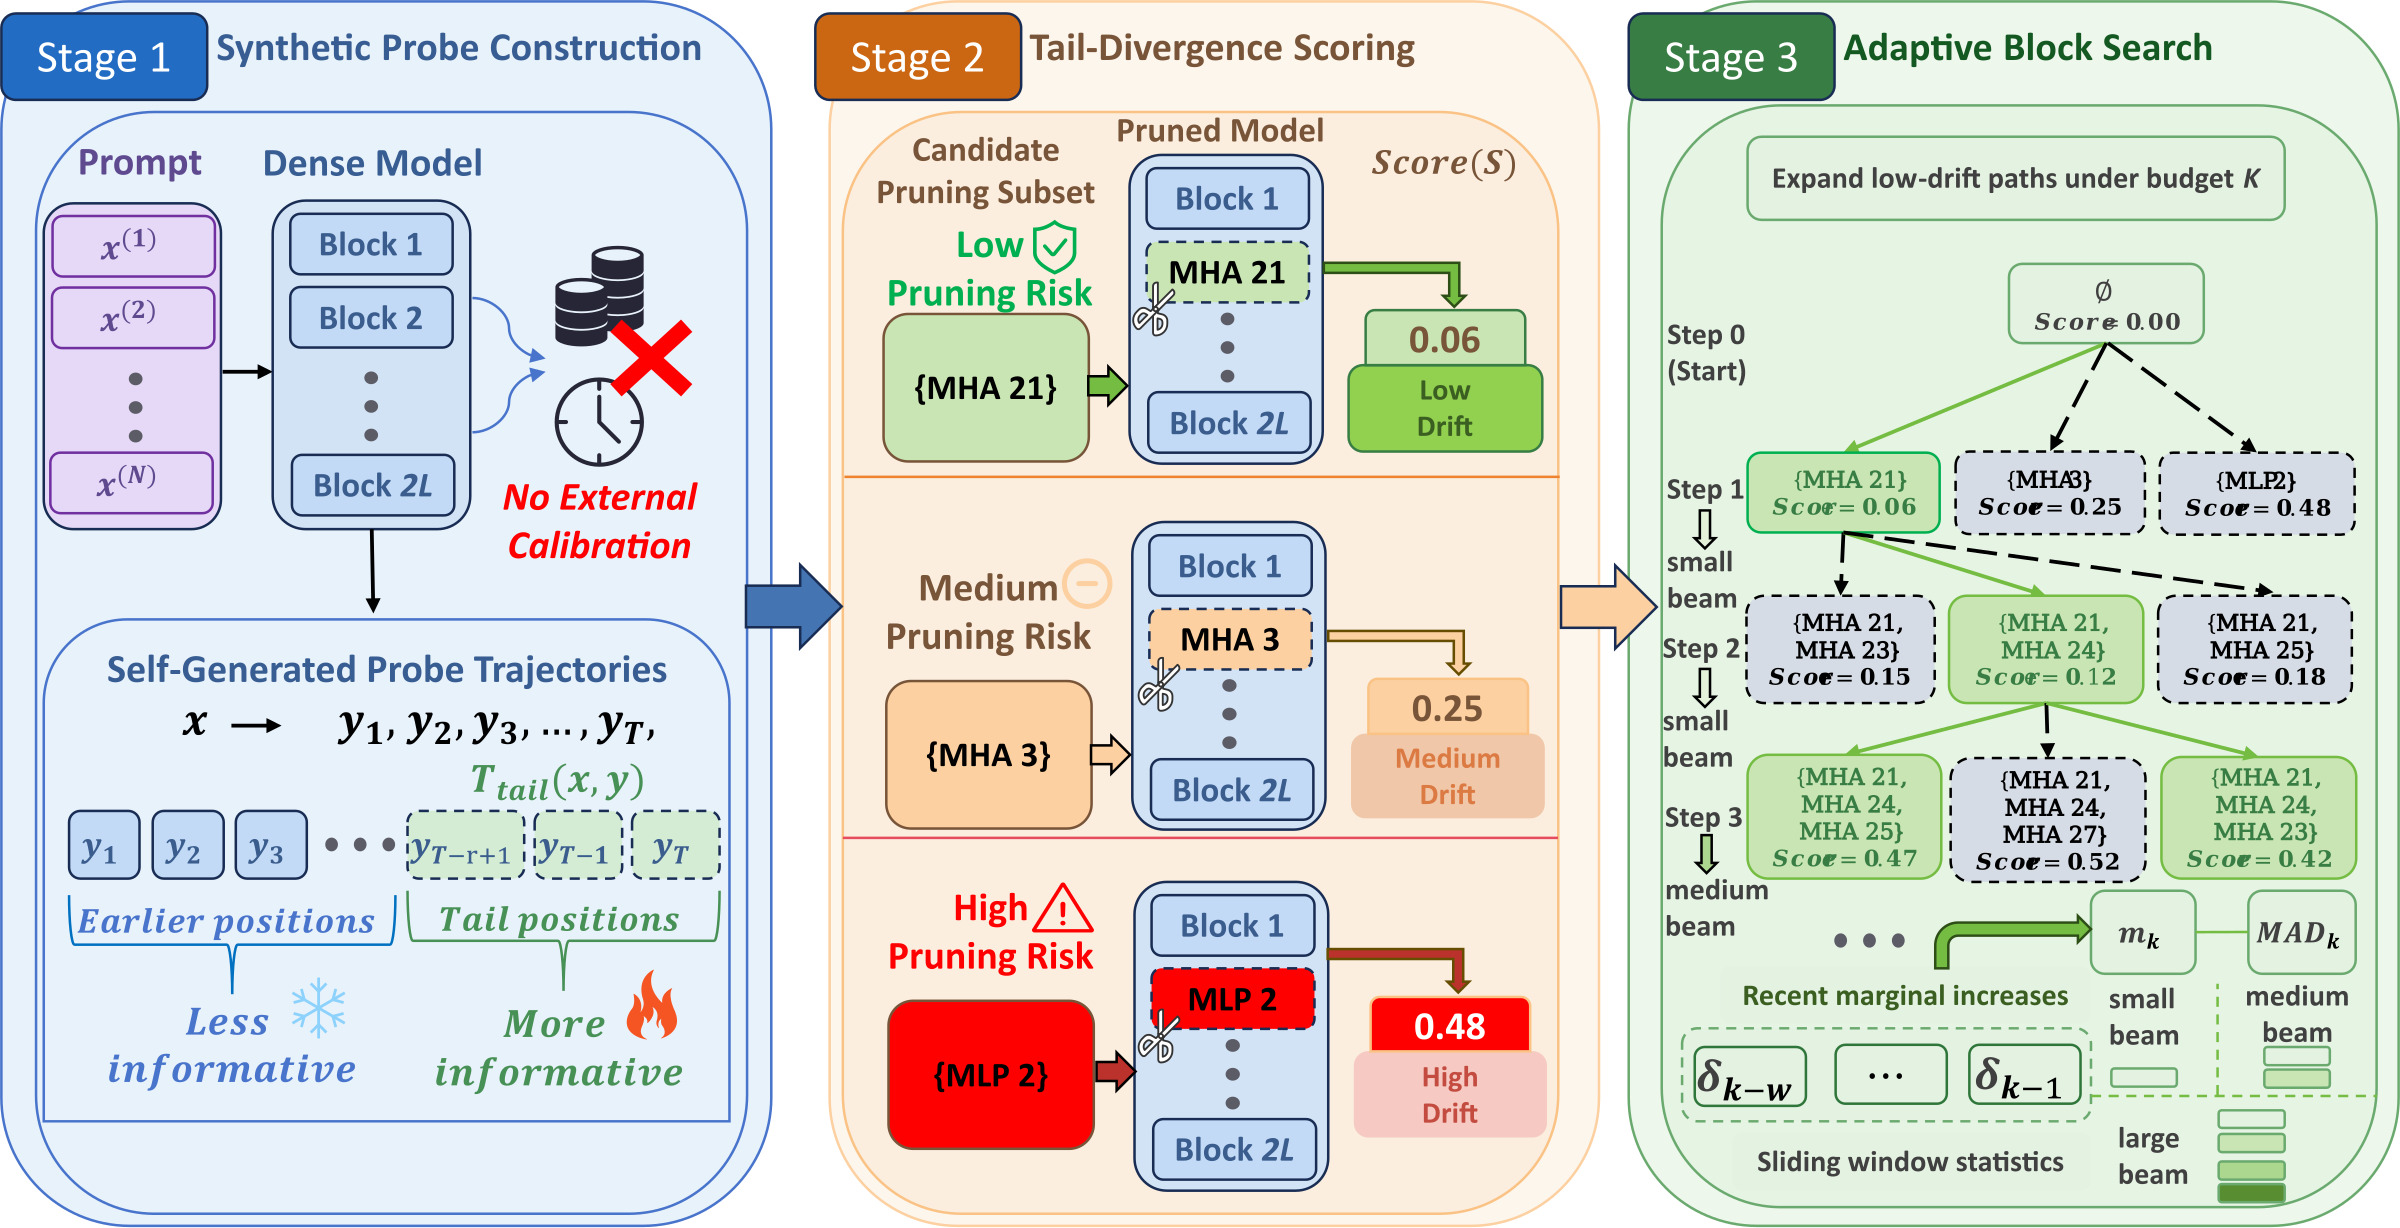
연구팀은 문장을 생성하는 과정에서 작은 예측 차이가 뒤로 갈수록 누적된다는 점에 주목했습니다. GDPruner는 원본 모델이 직접 생성한 문장을 기준으로, 블록을 제거한 후보 모델의 예측이 원본에서 얼마나 벗어나는지를 ‘생성 드리프트(Generation Drift)’로 측정합니다. 특히 차이가 가장 잘 드러나는 문장 후반부를 집중 분석하고, 여러 블록을 함께 제거했을 때의 영향까지 평가하며, 드리프트가 급격히 커지면 탐색 범위를 넓힙니다. 이 과정 전체에 별도의 외부 보정 데이터가 필요하지 않습니다.
여러 언어모델과 평가 과제를 대상으로 한 실험에서 GDPruner는 대부분의 조건에서 기존 경량화 기법보다 높은 성능을 보였고, 특히 블록을 많이 제거한 상황에서도 수학과 코드 성능을 잘 유지했습니다. 경량화된 모델은 같은 측정 환경에서 원본보다 문장 생성 속도가 빨라졌으며, 대규모 모델과 전문가 혼합(MoE) 구조에도 적용할 수 있음을 확인했습니다.
이번 연구는 생성에 꼭 필요한 연산만 남겨 추론 비용을 낮추는 방향을 제시했다는 점에서, 제한된 자원으로 생성형 AI를 운영하는 데 도움이 될 것으로 기대됩니다. 국가AI연구거점은 앞으로도 AI의 효율성과 신뢰성을 높이는 연구 성과를 국내외 AI 커뮤니티에 지속적으로 소개해 나갈 예정입니다.