연구
국가 AI 연구거점 참여 여진영 교수팀, COLM·EMNLP서 절차 준수 에이전트·3D 장면 평가 연구 발표
국가AI연구거점(NAIRL) 참여 연구진인 연세대학교 인공지능학과 여진영 교수 연구팀이 COLM 2026과 EMNLP 2026에서 AI 에이전트의 운영 절차 준수 학습과 텍스트 기반 3D 장면 생성 평가에 관한 연구 성과 2건을 발표합니다. 이번에 발표되는 연구는 각각 에이전트가 과제를 ‘정해진 방식대로’ 수행하도록 학습시키는 문제와, 생성된 3D 환경이 사용자 설명의 세부 요구사항을 얼마나 충실히 반영하는지 검증하는 문제를 다룹니다.
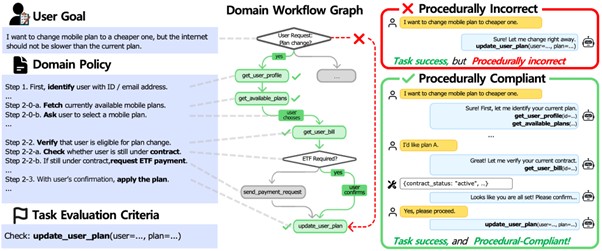
첫 번째 연구인 「Learning to Comply: Workflow-Grounded Environment Generation for Training Procedurally Compliant Agents」는 COLM 2026에서 발표되며, 실제 환경에 투입되는 AI 에이전트에게는 과제 해결 자체만으로는 충분하지 않다는 문제의식에서 출발합니다. 요금제 변경 전에 사용자 신원을 확인하거나 계약 조건을 검토하는 것처럼, 과제를 어떤 절차에 따라 수행해야 하는지를 규정하는 행동 정책과 운영 절차를 함께 따라야 하기 때문입니다. 그러나 이러한 ‘절차 준수(procedural compliance)’를 체계적으로 학습시키는 방법은 학습 환경 구축과 준수 행동에 대한 보상 설계 양 측면 모두에서 충분히 탐구되지 않았습니다.
연구팀은 KAIST, LG AI연구원, 업스테이지 연구진과 협력해 실행 가능한 도구 사용 환경과 과제를 정답 실행 경로와 함께 자동으로 생성하는, 확장 가능하고 검증 가능한 파이프라인을 구축했습니다. 또한 절차를 잘 따른 행동에 보상을 주는 두 가지 방식, 즉 에이전트의 행동 하나하나에 점수를 매기는 방식과 과제를 끝낸 뒤 전체 과정을 통째로 평가하는 방식을 비교했습니다. 절차 준수가 요구되는 여러 벤치마크 실험 결과, 두 방식 모두 각 환경에 맞게 보상을 설계했을 때 효과가 있었으며, 행동 단위 보상은 어떤 행동이 중요한지 학습하는 데, 전체 과정 보상은 절차 전반의 준수 여부를 판단하는 데 강한 신호를 제공하는 것으로 나타났습니다. 이를 통해 연구팀은 확장 가능한 환경 구축과 준수 인식 보상 설계가 절차에 기반한 에이전트 학습에 모두 필수적임을 보였습니다.
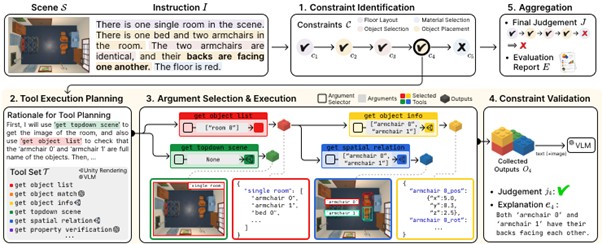
또다른 연구인 「Apples on the Table? Evaluating Text-Guided 3D Scene Synthesis via Fine-Grained Constraint Verification」는 EMNLP 2026 본학회에서 발표되며, 체화형 에이전트 개발에 핵심적인 텍스트 기반 3D 장면 생성의 평가 문제를 다룹니다. 기존 평가 방법은 생성된 장면과 사용자 설명 사이의 대략적인 유사도만 측정하거나, 객체 배치를 검증하는 데 필요한 공간 추론을 고려하지 않아, “X가 Y한 방식으로 장면에 있어야 한다”와 같이 설명에 담긴 세부 제약 조건을 제대로 검증하지 못했습니다.
연구팀은 POSTECH 연구진과 협력해 사용자 설명마다 사람이 주석한 제약 조건과 참조 장면을 짝지은 벤치마크 데이터셋 LEGO와, 설명을 작은 확인 항목들로 쪼갠 뒤 하나씩 검증하는 평가 프레임워크 LEGO-EVAL을 제안했습니다. 예를 들어 “침대 하나와 똑같은 안락의자 두 개가 등을 맞대고 놓인 방”이라는 설명은 침대가 있는지, 두 의자가 같은 것인지, 등을 맞대고 있는지 같은 항목으로 나뉘고, 각 항목은 3D 장면에서 해당 물체를 찾아 위치 관계를 따져 보는 방식으로 확인됩니다. 연구 결과 LEGO-EVAL은 기존 방법보다 훨씬 정확하게 장면과 설명의 불일치를 평가했으며, 현재의 장면 생성 기법들은 LEGO-EVAL 기준으로 최대 10%의 성공률에 그쳐 이 분야에 상당한 개선 여지가 있음을 드러냈습니다.
이번 성과는 AI 에이전트가 실제 환경에서 신뢰성 있게 작동하기 위한 두 가지 조건, 즉 행동을 규정하는 절차를 따르는 것과 정밀하고 검증 가능한 기준으로 평가받는 것을 함께 탐구했다는 점에서 의미가 있습니다. 국가AI연구거점은 앞으로도 에이전트의 신뢰성, 평가, 실제 세계 적용 가능성을 다루는 연구 성과를 국내외 AI 커뮤니티에 지속적으로 소개해 나갈 예정입니다.
LEGO-Eval 프로젝트 페이지: https://gyeomh.github.io/LEGO-Eval/